
CSV не помещается в Excel: как разделить выгрузку
Выгрузка сформирована, размер файла правдоподобен, но сотрудник не видит в Excel весь набор записей. Повторное сохранение первых видимых строк может превратить ограниченный просмотр в неполный рабочий файл. Сначала выясните, сколько записей ожидается, какое приложение их открывает и куда именно загружаются данные. Ограничение листа и допустимый объём исходного формата — разные вопросы.
Рассмотрим подготовку набора CSV для обычного просмотра на листах Excel. Это не обещание открыть любой файл на любом компьютере и не инструкция менять настройки рабочей базы. Числа в примере вымышленные, файлы большого объёма здесь не создаются. Для собственной задачи ещё нужно проверить структуру, используемые версии и доступные ресурсы программы.
Предел листа учитывается вместе с заголовком
В спецификации Microsoft для перечисленных современных версий Excel указан предел листа: 1 048 576 строк и 16 384 столбца. Если первая строка занята заголовком, для данных остаётся 1 048 575 строк. Это ограничение листа, а не универсальное утверждение, что сам CSV не может содержать больше записей или что любые другие способы анализа имеют тот же предел.
Уточните, что сотрудник собирается сделать: просмотреть все записи, получить выборку или построить итог. Иногда достаточно отдельного проверяемого отчёта вместо открытия полного исходника. Если требуются именно части для ручной работы, нужно согласовать структуру набора и порядок их использования. Не называйте случайное обрезание файла допустимым сокращением без явного решения владельца задачи.
Допустимое количество строк не гарантирует удобство. Много столбцов, длинные значения и особенности обработки влияют на ресурсы. Выбирайте размер части по проверяемому примеру своей среды, а не обещайте одинаковую скорость на всех компьютерах. Формат и программа назначения должны быть известны до разработки автоматического разделения.
Учебный набор из 1 200 000 записей
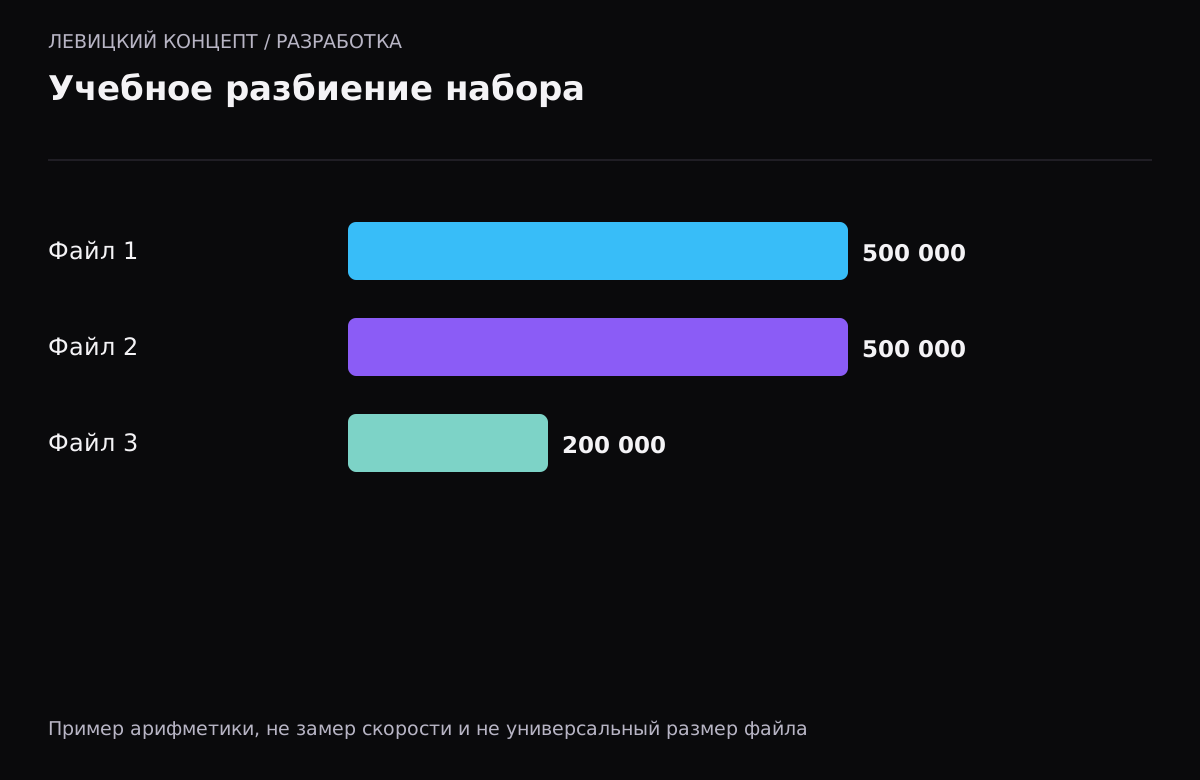
Представим выгрузку с 1 200 000 логических записей данных и одним заголовком. Для учебной схемы выберем части не больше 500 000 записей данных. Тогда потребуются три файла: 500 000, 500 000 и 200 000. Заголовок повторяется в каждом. На соответствующих листах получится 500 001, 500 001 и 200 001 строка.
Полмиллиона выбрано только для объяснения. Это не обязательный размер блока и не рекомендация создавать такой объём без проверки ресурсов. Главное — отличать число данных от числа служебных строк и знать, какие части образуют один набор. Последняя меньшая часть не является ошибкой, если она соответствует ожидаемому остатку.
| Часть учебной выгрузки | Записей данных | Заголовков | Строк после разбора на лист |
|---|---|---|---|
| Файл 1 | 500 000 | 1 | 500 001 |
| Файл 2 | 500 000 | 1 | 500 001 |
| Файл 3 | 200 000 | 1 | 200 001 |
| Весь набор | 1 200 000 | 3 | 1 200 003 суммарно |
Последнее значение — сумма по трём частям, не требование разместить всё на одном листе. При обратном объединении служебные заголовки не должны превращаться в дополнительные записи данных. В сопроводительном описании укажите, что учитывается в каждом счётчике. Одно поле «всего строк» без определения снова создаст неоднозначность.
Разделять нужно записи, а не произвольные переводы строки
В описании CSV RFC 4180 предусмотрены заключённые в кавычки поля с переводами строки. Поэтому физическая строка текстового файла не всегда совпадает с одной логической записью. Механическое разрезание после заданного количества переносов может повредить значение, даже если число получившихся файлов выглядит правильным.
Для обработки нужен разбор согласованного формата. Определите разделитель, наличие заголовка, кодировку и правила кавычек. На входе могут использоваться особенности конкретной системы, поэтому одного расширения файла недостаточно. Сохраните эти параметры вместе с набором, чтобы следующий сотрудник не выбирал их заново наугад при каждом открытии.
Проверьте пример с многострочным учебным комментарием и разделителем внутри значения. После разделения и повторного чтения содержимое должно сохранить смысл, а число записей — не увеличиться из-за комментария. Не упрощайте проверку до отсутствия сообщения об ошибке. Программа может принять файл и неверно интерпретировать отдельные столбцы.
Сопроводительный список помогает найти недостающую часть
У набора полезно хранить идентификатор выгрузки, момент формирования, параметры отбора и перечень файлов. Для каждой части запишите порядковый номер, ожидаемое количество записей и согласованную проверку целостности. Конкретный формат описания зависит от проекта. Он должен позволять отличить комплект одного запуска от похожих файлов другого дня.
Не полагайтесь только на имя «часть 2». При повторной генерации может появиться другой второй файл с тем же именем. Сохраните связь с конкретным запуском. Если используются контрольные суммы, они помогают проверить совпадение содержимого с заявленным файлом, но сами по себе не доказывают правильность исходной выборки или полноту данных источника.
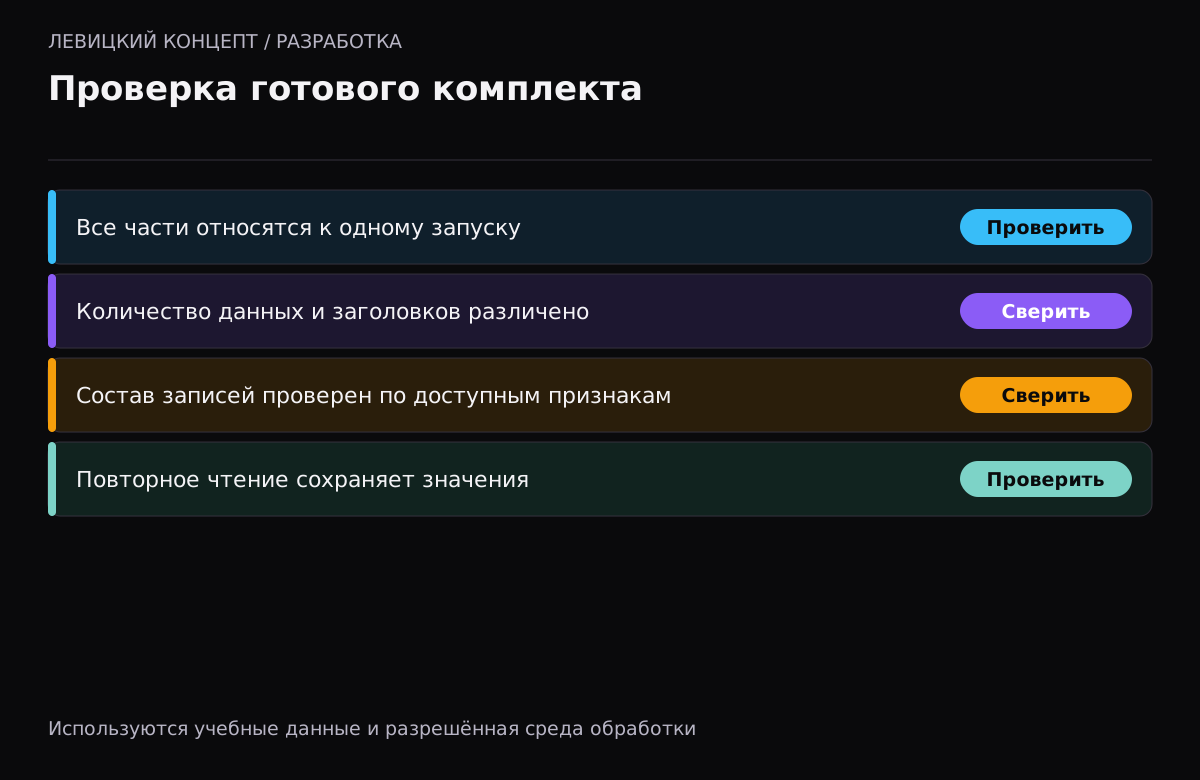
После передачи сотрудник должен понимать, все ли части получены. Отсутствующий файл, повтор одной части и смешение запусков — разные ошибки. Общая сумма размеров архива не заменяет такую проверку. В интерфейсе программы обработки можно показать явный результат комплектности до начала объединения или последующего анализа.
Одинаковое количество ещё не доказывает отсутствие потерь
Сумма 500 000 + 500 000 + 200 000 проверяет арифметику учебного разбиения. Но набор с одной пропущенной и одной повторённой записью может иметь то же количество. Если источник даёт устойчивые идентификаторы, согласуйте проверку состава по ним. Если таких признаков нет, обозначьте ограничения доказательства полноты.
Для выбранной задачи определите допустимые повторы. Одинаковые значения нескольких полей не обязательно означают ошибочный дубль, а различающееся оформление не делает записи независимыми. Не запускайте автоматическое удаление похожих строк без согласованного смысла. Разделение файла должно сохранить исходный набор, если отдельно не заказана проверяемая очистка.
Согласуйте порядок записи. Если он важен сотруднику, нужно сохранить его понятное основание. Если данные выгружаются из меняющегося списка, проблема может возникнуть ещё до разделения CSV. Такой случай разобран в статье про пропуски и повторы в выгрузке CRM. Здесь проверяется сохранение уже определённого набора при подготовке частей.
Типы полей проверяют отдельно от количества
Номер договора, код товара или другой идентификатор может выглядеть как число, но требовать текстового представления. Подготовка частей не гарантирует, что выбранный способ открытия сохранит ведущие нули и исходные значения. Проверьте контрольные поля до массового использования. Подробности разбора кавычек и импорта вынесены в соседний материал, чтобы не смешивать две задачи.
Не считайте уменьшение размера файла основанием менять структуру данных. Удаление столбца, округление значения или преобразование даты должны иметь собственное согласование. Иначе программа разделения незаметно станет преобразователем с потерей смысла. Для результата полезен явный список выполняемых операций и того, что остаётся неизменным.
Для демонстрации достаточно небольших искусственных примеров с теми же особенностями. Не нужно загружать настоящую клиентскую выгрузку в случайный онлайн-сервис ради проверки разделителя. Среду обработки, доступ и хранение выбирают по требованиям проекта. Статья не определяет юридический режим конкретных данных и не предлагает обходить ограничения используемых систем.
Ошибка обработки не должна оставлять готовый на вид комплект
Если выполнение остановилось после второй части, полученные файлы ещё не образуют полный набор. Программа должна различать незавершённый запуск и подтверждённый результат. Не публикуйте итоговое сообщение «готово» только по факту появления первого файла. Ожидаемое количество частей и проверка всех записей входят в приёмку.
При повторе операции определите, какие файлы относятся к новому запуску. Случайное дописывание к прежним частям может создать дубли. Сохраните исходник и возможность проверить результат, не требуя изменять рабочую базу. Порядок возобновления выбирают по устройству обработки, а не обещают универсальное продолжение с любого места.
Для задания на разработку подготовьте структуру CSV, размер ожидаемого набора, программу назначения и несколько учебных особых значений. На демонстрации проверьте число записей, заголовки, состав частей и повторное чтение. Так можно принять программу автоматизации по сохранению данных и понятному результату, а не только по уменьшившемуся размеру файлов.
Материалы для проверки
Если нужна реализация
Состав работ зависит от текущего проекта и подтверждённой причины. Можно обсудить диагностику или разработку подходящего решения.
Вопросы и ответы
Предел строк Excel ограничивает сам формат CSV?
В статье речь о пределе обычного листа Excel. CSV может содержать больше записей, но выбранный способ просмотра должен поддерживать нужный объём.
Нужно учитывать заголовок при разбиении?
Да, если он занимает строку листа. В учебной части из 500 000 записей данных и одного заголовка получится 500 001 строка после разбора.
Можно разрезать файл после заданного количества переводов строки?
Не для общего случая CSV. Внутри заключённого в кавычки поля может быть перевод строки, поэтому разделение должно учитывать логические записи согласованного формата.
Достаточно совпадения общего количества записей?
Это полезная, но неполная проверка. Пропуск и повтор могут взаимно компенсироваться по числу, поэтому состав проверяют по доступным устойчивым признакам и фиксируют ограничения.