
Защита сайта от парсинга: что работает, а что мешает людям
Содержание · 7
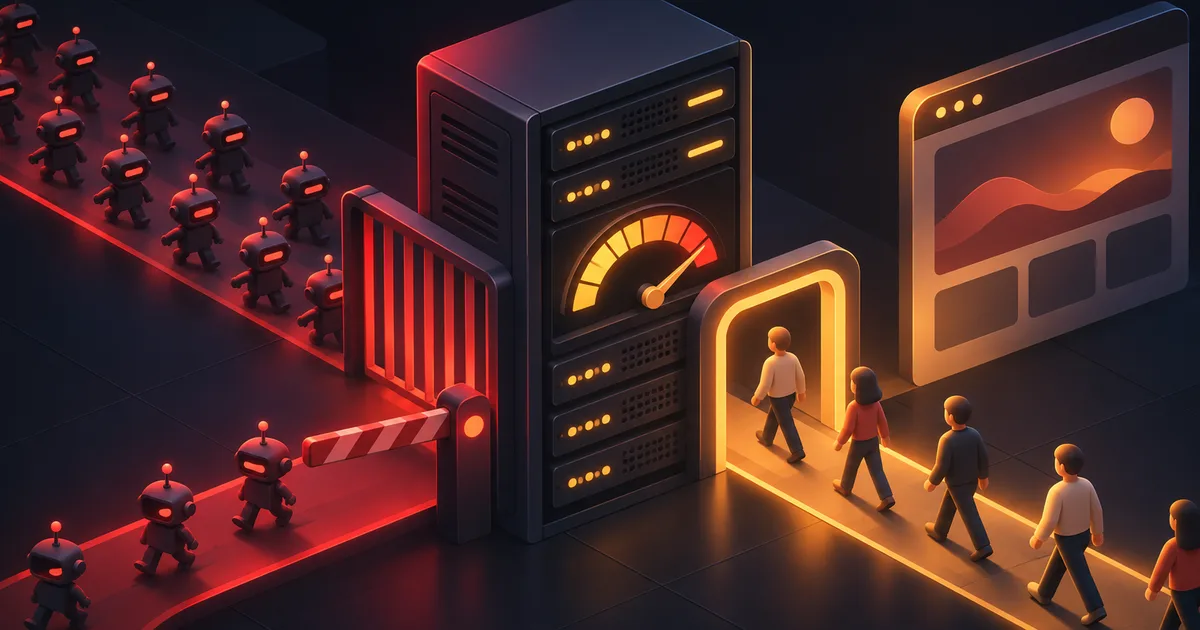
Защитить сайт от парсинга на 100% нельзя: всё, что видит посетитель, видит и программа. Реально сделать так, чтобы массовый сбор данных стал медленным, дорогим и заметным для вас. Работает связка из четырёх мер: ограничение частоты запросов, распознавание ботов, отдача данных через контролируемый API и юридические оговорки. Капча на каждой странице к ним не относится: она раздражает людей и плохо останавливает современных ботов.
Что вы защищаете и от кого
Сначала определите, что именно уходит. Для интернет-магазина это цены и остатки, для каталога услуг контакты, для медиа тексты, для сервиса записи базы клиентов. От этого зависит выбор мер. Также важно понимать, кто приходит: поисковые роботы нужны вам, конкурентские парсеры нет, а часть автоматического трафика (мониторинг цен, агрегаторы) вы можете разрешить на своих условиях.
О том, что вообще считается допустимым парсингом, мы писали в обзоре парсер цен конкурентов: сколько стоит и законно ли. Здесь смотрим на ту же ситуацию глазами владельца сайта.
Меры по уровням
| Уровень | Мера | Что даёт | Побочный эффект |
|---|---|---|---|
| 1. Основы | Ограничение запросов с одного IP и по пользовательскому аккаунту (rate limit) | Режет грубый перебор страниц | Могут пострадать общие офисные IP, ставьте разумный порог |
| 1. Основы | Мониторинг логов: много запросов за минуту, перебор номеров в адресах | Видно, кто и что собирает | Нужен человек или оповещения |
| 2. Фильтрация | WAF и анти-бот сервис (Cloudflare, Яндекс Smart Web Security и аналоги) | Отсев известных ботов и подозрительного поведения | Нужно следить, чтобы не блокировались поисковые роботы: Googlebot получает капчу |
| 2. Фильтрация | Проверка User-Agent и заголовков | Отсекает простые скрипты | Подделывается за секунду, как единственная мера бесполезна |
| 3. Данные | Контакты и цены только после входа или по запросу | Закрывает массовый сбор | Меньше удобства для посетителей |
| 3. Данные | Официальный API или выгрузка (YML, CSV) для партнёров | Парсить больше нет смысла | Нужна поддержка и ключи доступа |
| 4. Право | Условия использования, указание на авторские права, robots.txt | Основа для претензии | robots.txt не защищает, это просьба, а не запрет |
Что не стоит делать
- Блокировать целые страны и сети хостинга без анализа. Вместе с парсерами вы потеряете клиентов и иногда поисковых роботов.
- Прятать данные в картинки. Это ломает доступность, поиск и удобство, а ИИ-распознавание читает текст с картинки не хуже человека.
- Подменять данные «ловушками» для людей. Ложные цены или остатки подрывают доверие клиентов.
- Ставить капчу на каждую страницу. Конверсия падает быстрее, чем парсеры замечают препятствие.
- Закрывать сайт от поисковых систем. Проверяйте, что Яндекс и Google по-прежнему получают страницы.
Порядок внедрения
- Посмотрите логи за неделю. Найдите IP и адреса с аномальным числом запросов в минуту.
- Поставьте мягкие лимиты и замерьте, не задеты ли обычные посетители.
- Подключите WAF или анти-бот сервис в режиме наблюдения, затем переключите на блокировку.
- Отдельно проверьте доступ поисковых роботов через официальные инструменты Вебмастера и Search Console.
- Для важных данных (цены, контакты) добавьте вход или API.
- Опубликуйте условия использования данных сайта и храните доказательства: логи, скриншоты, даты.
- Раз в месяц просматривайте отчёты и корректируйте пороги.
Юридическая сторона
Если парсер копирует ваши тексты, фотографии или базу целиком, можно направить претензию владельцу сайта или хостингу, а при необходимости обращаться в суд. Чтобы шансы были, сохраняйте журналы запросов, даты публикации оригиналов и ссылки на копии. Подробную квалификацию действий даст юрист, мы не даём юридических заключений.
Как отличить парсер от обычного трафика
В логах парсер выдаёт себя регулярностью. Запросы идут ровными интервалами, без загрузки картинок и скриптов, с одного адреса или из блока адресов хостинга, часто перебирают страницы подряд: карточки с номерами по возрастанию, страницы пагинации, поисковые запросы по алфавиту. Живые посетители читают и уходят, у них разный путь по сайту.
- сотни запросов к карточкам за минуту с одного адреса;
- отсутствие запросов к CSS, картинкам и скриптам;
- обращения к служебным адресам: фиду, поиску, внутреннему API;
- подмена User-Agent под известный браузер при необычном поведении;
- запросы ночью по ровным интервалам.
Перед блокировкой отличайте парсер от поискового робота. Настоящих роботов Яндекса и Google подтверждают обратной проверкой DNS по инструкциям Яндекса и Google.
Для интернет-магазинов защита от автоматического сбора входит в общий пакет мер: защита интернет-магазина. Базовую настройку лимитов и фильтрации можно получить в рамках поддержки сайта.
Вопросы и ответы
Можно ли полностью защитить сайт от парсинга?
Нет. Любые данные, которые видит человек, может собрать и программа. Цель защиты в том, чтобы сделать сбор дорогим, медленным и заметным.
Поможет ли robots.txt?
Только против добросовестных роботов, которые читают файл. Недобросовестные парсеры его игнорируют, поэтому полагаться на него для защиты нельзя.
Не повредит ли защита от парсинга SEO?
Может, если случайно заблокировать поисковых роботов. После настройки WAF и лимитов проверьте доступ в Яндекс Вебмастере и Google Search Console.
Что защищает лучше всего?
Совокупность мер: лимиты запросов, анти-бот фильтр и доступ к ценным данным через вход или API. Одна мера, особенно капча, обычно не решает задачу.
Парсинг вообще законен?
Это зависит от того, что и как собирается: открытые факты и авторские материалы с базами данных защищены по-разному. Спорные случаи оценивает юрист.
Читайте также
Защита от шифровальщиков: чек-лист для небольшой компании
БезопасностьЗащита сайта от DDoS: что реально работает
БлокчейнОракулы в блокчейне: манипуляция ценой и защита контракта
КомментарииChrome в 2026: седьмой 0-day и защита от атак ClickFix
НовостиСбой Curator 8 октября: когда защита от DDoS сама кладёт сайт