
Авария Yandex Cloud в октябре 2026: что отказало и что выдержало
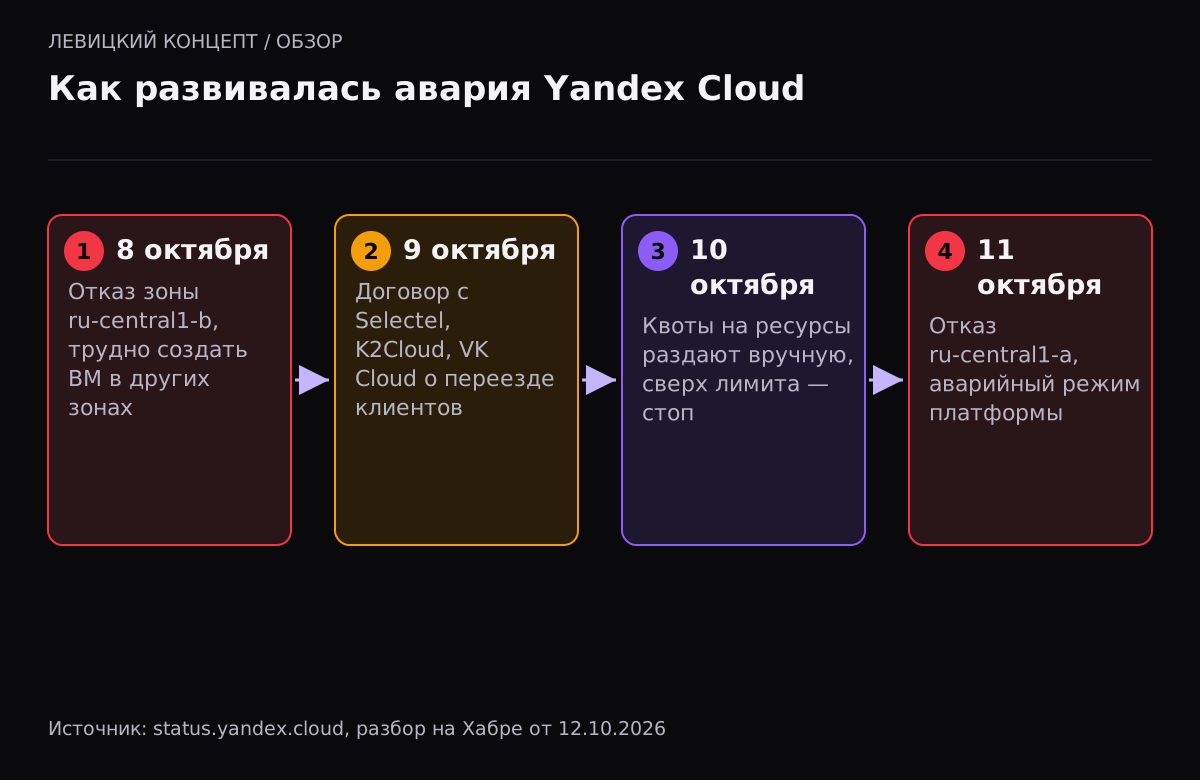
С 8 по 11 октября 2026 года Yandex Cloud последовательно потерял две зоны доступности из трёх основных: сначала ru-central1-b (площадка в Сасове), затем ru-central1-a (Владимир). Платформа перешла в аварийный режим, у части клиентов перестали работать базы данных, кластеры Kubernetes и запись в объектное хранилище. Ниже — хронология по официальным сообщениям и разбор того, какие архитектурные решения сработали, а какие нет.
Что произошло: хронология по дням
8 октября, 01:31 мск. Yandex Cloud сообщил о перебоях с электропитанием в зоне ru-central1-b. Клиентам предложили переносить нагрузку в другие зоны. К 04:55 начались сложности с созданием виртуальных машин, кластеров Managed Kubernetes и баз данных уже в остальных зонах: туда одновременно ринулись все, кто переезжал. Днём компания подтвердила пожар и полную остановку площадки, вечером предложила альтернативы, включая выделенные физические серверы.
9 октября. Сообщалось о повреждении ещё одного дата-центра, в Калуге. В блоге Yandex Cloud вышло заявление: оценить сроки восстановления оборудования «очень сложно». Компания договорилась с Selectel, K2Cloud и VK Cloud об ускоренном переезде клиентов. Во второй половине дня появилась возможность выносить управляющие компоненты региональных кластеров Kubernetes из зоны b и исключать её хосты из управляемых БД.
10 октября. Выдачу квот на вычисления и диски перевели в ручной режим. Создание ресурсов сверх лимитов заморозили, приоритет получили клиенты с упавшими критичными сервисами.
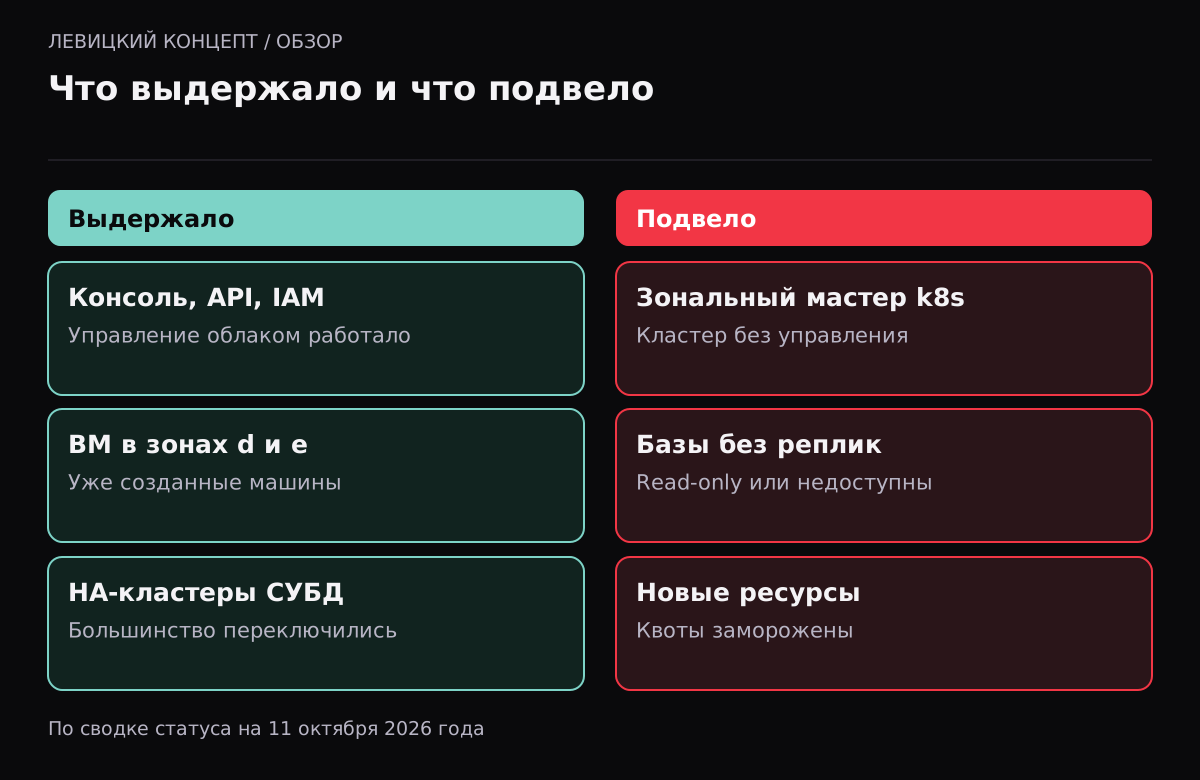
11 октября, 04:00 мск. Нарушение электропитания в зоне ru-central1-a. К утру площадку остановили полностью, платформа перешла в аварийный режим. Вычисления остались доступны в зонах ru-central1-d и ru-central1-e. Консоль, API и IAM работали. Большинство отказоустойчивых кластеров СУБД переключились на уцелевшие узлы, но часть баз стала доступна только на чтение или не открывалась вовсе. В объектном хранилище чтение работало, запись могла выдавать ошибки. Днём выдачу дополнительных квот приостановили полностью.
13–20 октября. Сервисы Яндекса и клиентов возвращались поэтапно. 13 октября Yandex Cloud объявил, что использование ресурсов с 8 по 31 октября для текущих клиентов будет бесплатным. 14 октября Минцифры сообщило, что ключевые системы переведены на заранее подготовленные резервные площадки.
| Компонент | Что было с ним | Вывод для архитектуры |
|---|---|---|
| Консоль, API, IAM | Работали | Управление облаком пережило потерю двух зон |
| Виртуальные машины | Работали в зонах d и e | Новые ВМ создать было почти нельзя: квоты заморожены |
| Управляемые СУБД | Большинство HA-кластеров переключились, часть ушла в read-only | Кластер из одного узла в упавшей зоне не спасает ничто |
| Kubernetes | Часть кластеров неуправляема | Зональный мастер в упавшей зоне — точка отказа |
| Object Storage | Чтение да, запись с ошибками | Очереди загрузки файлов нужно уметь копить |
Почему мультизональность помогла не всем
Классическая схема «размести сервис в трёх зонах» предполагает, что выпадет одна зона и ненадолго. В октябре сценарий был другим, и он вскрыл три слабых места.
Резерв ёмкости. Мультизональность работает, только если в уцелевших зонах хватает мощности принять нагрузку выбывших. Если у вас 50% ресурсов в одной зоне и вы рассчитывали «досоздать» машины после аварии, этого может не получиться: в октябре квоты сначала раздавали вручную, а потом выдачу остановили.
Управляющий слой. Зональный мастер Kubernetes в поражённой зоне делает кластер неуправляемым, даже если рабочие узлы живы в других зонах. Региональный мастер — дороже, но именно он позволил части клиентов продолжать работу.
Единый провайдер. Даже идеальная раскладка по зонам не защищает от того, что общие компоненты — IAM, биллинг, внутренний DNS, парк оборудования — принадлежат одному провайдеру. Автор подробного разбора на Хабре называет внешние бэкапы и холодный резерв у второго провайдера «минимальной гигиеной».
Кого это касается
- Компаний, у которых сайт, CRM или учётная система размещены в Yandex Cloud в одной зоне.
- Тех, кто пользовался управляемыми БД без реплик в других зонах.
- Владельцев сервисов, которые сами не арендовали облако, но зависят от подрядчиков в нём: платёжных шлюзов, сервисов рассылок, ЭДО. Например, 11 октября перестали работать сервисы 1С-Отчётность и 1С-ЭДО, инфраструктура оператора которых размещалась у Яндекса.
Что сделать сейчас
- Выпишите все свои сервисы и для каждого — зону, где он живёт. Отдельно отметьте управляемые БД и мастер Kubernetes.
- Проверьте, хватит ли мощности в оставшихся зонах, если выпадет любая одна. Калькулятор ниже считает это по vCPU; повторите для памяти.
- Держите резерв заранее, а не рассчитывайте создать машины во время аварии.
- Вынесите копии данных за пределы провайдера: другой облачный оператор или свой сервер.
- Проверьте восстановление из копии на практике и засеките время. Цифра RTO на бумаге и реальное время — разные вещи.
- Держите DNS и внешний мониторинг у независимого провайдера, понизьте TTL ключевых записей до 300 секунд — так переключение займёт минуты.
Наше мнение
Мы не считаем, что из этой истории следует «уходить из облака». Большая часть платформы пережила потерю двух площадок, а консоль, IAM и API работали всё время. Слабым местом оказались не облачные технологии, а предположения: что выпадет одна зона и что мощности после аварии можно будет докупить. Для малого бизнеса разумный минимум — ежедневная копия данных у второго провайдера и проверенный план, как поднять сайт и CRM там за несколько часов. Горячее зеркало оправдано, когда час простоя стоит дороже месяца второй площадки.
Переживёт ли сервис потерю зоны
Считает по одному ресурсу (vCPU): сколько останется, если откажет любая одна зона, и худший случай для двух зон. Для памяти и дисков повторите расчёт. Не учитывает, что после аварии свободных мощностей у провайдера может не быть. Расчёт выполняется на вашем устройстве, введённые данные никуда не отправляются.
Материалы для проверки
Если нужна реализация
Состав работ зависит от текущего проекта и подтверждённой причины. Можно обсудить диагностику или разработку подходящего решения.
Вопросы и ответы
Восстановлены ли зоны ru-central1-b и ru-central1-a?
На момент публикации компания не называла сроков полного восстановления площадок. Актуальный статус смотрите на status.yandex.cloud: там же публикуются рекомендации по переносу нагрузки.
Если у меня всё было в зоне ru-central1-d, меня это коснулось?
Напрямую ресурсы в зоне d работали, но могли пострадать зависимости: базы с репликой в другой зоне, мастер Kubernetes, сторонние сервисы. Кроме того, в октябре нельзя было свободно создавать новые ресурсы.
Что дешевле для малого бизнеса — три зоны или второй провайдер?
Для сайта и CRM обычно дешевле ежедневная копия у второго провайдера и проверенный план развёртывания. Три зоны у одного провайдера защищают от локальной аварии, но не от серии отказов площадок.
Нужно ли срочно уходить из Yandex Cloud?
Мы не советуем решать это в спешке. Сначала вынесите копии данных наружу и отработайте восстановление. Переезд имеет смысл, если вы не можете уложиться в нужное время восстановления в текущей схеме.
Как проверить, что резервная копия действительно восстановится?
Разверните её на чистом сервере у другого провайдера, запустите сайт или CRM и проверьте вход, заявки и платежи. Время от начала до рабочего состояния — ваше реальное RTO.