
План восстановления после аварии на одной странице: урок октября
11 октября 2026 года, когда Yandex Cloud потерял вторую зону доступности, компания прямо рекомендовала клиентам планы аварийного восстановления за пределами облака. По хронологии «Т—Ж», сервисы Яндекса и их клиентов возвращались поэтапно до 20 октября. Разница между компаниями, которые вернулись за часы, и теми, кто ждал днями, во многом определялась одним документом: записанным и отрепетированным планом восстановления. Разбираем, как составить такой план на одной странице и посчитать, за сколько вы на самом деле переключитесь.
Почему план, а не «мы разберёмся»
В аварию решения принимаются в стрессе, часто ночью, и людьми, которые не каждый день работают с инфраструктурой. Без плана теряется время на очевидные вещи: где лежат доступы, кто принимает решение, в каком порядке поднимать сервисы, кого предупредить. Автор разбора аварии на Хабре отдельно советует регулярно проверять восстановление из копии и замерять реальное время, а не ориентироваться на цифры из документации.
Что должно быть на одной странице
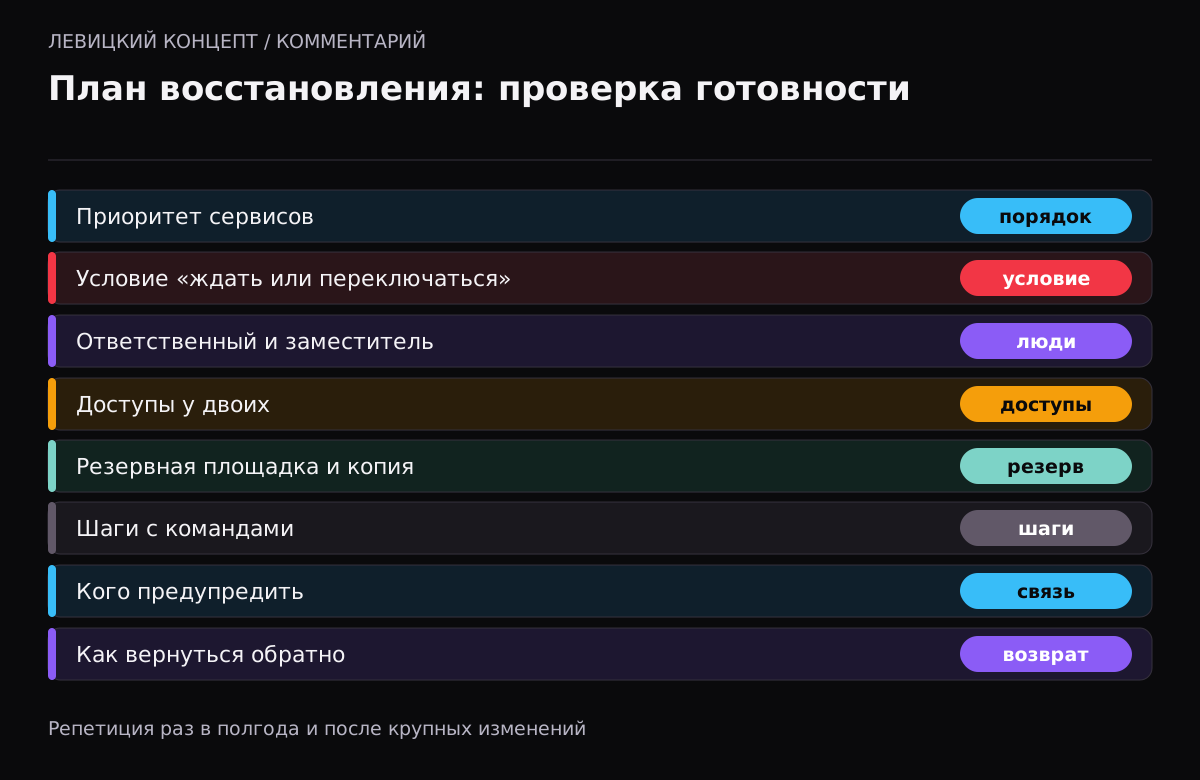
| Раздел | Что записать | Пример |
|---|---|---|
| Что спасаем первым | Список сервисов по приоритету | 1) оплата и заказы, 2) CRM, 3) сайт-витрина |
| Когда переключаемся | Условие запуска плана | Сервис недоступен более 30 минут и нет прогноза от провайдера |
| Кто решает | Ответственный и заместитель | Директор, при недоступности — руководитель продаж |
| Где доступы | Где хранятся пароли и ключи | Менеджер паролей, доступ у двоих |
| Куда переключаемся | Резервная площадка и копия данных | Второй провайдер, копия за прошлую ночь |
| Порядок действий | Шаги с командами или ссылками на инструкции | Развернуть ВМ, восстановить базу, сменить DNS |
| Кого предупредить | Клиенты, сотрудники, партнёры | Статус-страница, рассылка, чат поддержки |
| Как вернуться | Обратное переключение после восстановления | Синхронизация данных, смена DNS |
Как посчитать реальное время восстановления
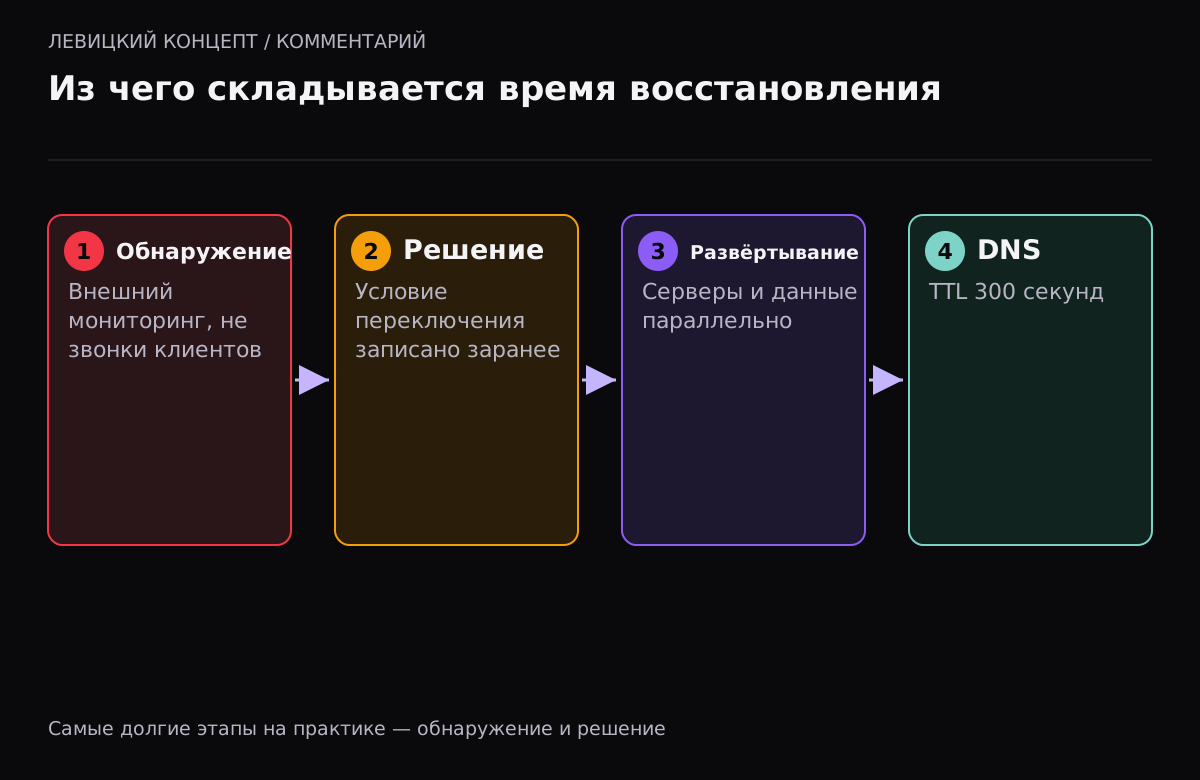
Время от начала аварии до работы на резервной площадке складывается из нескольких этапов:
- Обнаружение — сколько минут проходит, пока вы узнаёте о проблеме. Без внешнего мониторинга это часто час и больше: узнают из звонков клиентов.
- Решение — сколько времени уходит на то, чтобы решить переключаться, а не ждать.
- Развёртывание — поднять серверы и приложение на резервной площадке.
- Восстановление данных — развернуть копию базы и файлов; часто идёт параллельно с развёртыванием.
- Обновление DNS — посетители начнут попадать на новый адрес в пределах TTL записи.
Калькулятор ниже складывает эти этапы и сравнивает с вашей целью. Отдельно он показывает, данные за какой период вы можете потерять, — это интервал резервного копирования.
Что обычно оказывается самым долгим
На практике самые длинные этапы — не развёртывание, а обнаружение и решение. Компании ждут, что провайдер вот-вот восстановится, и откладывают переключение. Поэтому в плане важно заранее записать условие: «если через N минут нет прогноза — переключаемся». Это снимает с человека необходимость принимать трудное решение в момент аварии.
Вторая частая проблема — TTL. Если записи DNS имеют TTL в сутки, часть посетителей ещё сутки будет попадать на старый адрес. Понизьте TTL ключевых записей до 300 секунд заранее.
Пример плана для интернет-магазина
Для наглядности — как может выглядеть план небольшого магазина, который работает в облаке:
- Приоритет: приём заказов и оплаты, затем личный кабинет, затем блог.
- Условие: сайт недоступен 30 минут, провайдер не дал прогноза — переключаемся.
- Решает: директор; если он недоступен — руководитель продаж.
- Резерв: копия базы и файлов каждую ночь у второго провайдера, готовый образ сервера.
- Шаги: создать ВМ из образа, восстановить базу из последней копии, проверить оплату тестовым платежом, сменить A-запись в DNS.
- Связь: сообщение на статус-странице, рассылка покупателям с незавершёнными заказами.
- Возврат: после восстановления основной площадки перенести заказы, поступившие на резерве, и переключить DNS обратно ночью.
Такой план умещается на одну страницу и читается за пять минут. Главное — чтобы его прочитали до аварии, а не во время.
Типичные ошибки в планах
- План есть, но лежит там же, где упавший сервис — в вики или на диске в том же облаке. Храните копию плана отдельно, например в распечатке или в почте ответственных.
- В плане нет доступов — только ссылки на систему, в которую при аварии не войти.
- План писал человек, который уволился, и никто его не проверял.
Как отрепетировать
- Выберите спокойный день и предупредите сотрудников.
- Разверните резервную копию на резервной площадке строго по плану, не подсматривая в память опытного сотрудника.
- Засеките время каждого этапа.
- Проверьте ключевые сценарии: вход, заказ, оплата, отправка письма.
- Запишите, что в плане оказалось неверным или неполным, и исправьте.
Репетиция раз в полгода и после крупных изменений инфраструктуры — разумная частота для небольшой компании.
Что делать, если резервной площадки нет
Даже без второго провайдера план нужен. Он может выглядеть так: копия данных хранится вне основной площадки; при аварии арендуем сервер у другого провайдера по заранее выбранному тарифу и разворачиваем копию. Это дольше, чем готовый резерв, но в разы быстрее, чем искать провайдера и вспоминать порядок действий в момент аварии.
Наше мнение
Мы считаем, что план восстановления на одной странице — самая недооценённая мера надёжности для малого бизнеса. Он почти ничего не стоит, но превращает аварию из хаоса в последовательность действий. Мы советуем клиентам начать с него, а уже потом решать, нужна ли вторая площадка: часто после первой репетиции становится ясно, что главное узкое место — не техника, а доступы и решения.
За сколько вы переключитесь при аварии
Складывает этапы восстановления: обнаружение, решение, развёртывание и восстановление данных (параллельно, берётся большее), обновление DNS в пределах TTL. Оценка сверху. Реальные минуты берите с последней репетиции. Интервал резервного копирования показывает, данные за какой период можно потерять. Расчёт выполняется на вашем устройстве, введённые данные никуда не отправляются.
Материалы для проверки
Если нужна реализация
Состав работ зависит от текущего проекта и подтверждённой причины. Можно обсудить диагностику или разработку подходящего решения.
Вопросы и ответы
Чем план восстановления отличается от резервного копирования?
Копия — это данные. План — это порядок действий: кто решает, куда переключаемся, в каком порядке поднимаем сервисы и как предупреждаем клиентов.
Как часто репетировать восстановление?
Для небольшой компании разумно раз в полгода и после крупных изменений инфраструктуры.
Какой TTL ставить у DNS-записей?
Для ключевых записей — около 300 секунд. Тогда переключение займёт минуты, а не часы.
Что делать, если резервной площадки нет?
Храните копию данных вне основной площадки и заранее выберите провайдера и тариф, где развернёте её при аварии. Запишите порядок действий.
Кто должен знать план?
Как минимум ответственный и его заместитель. Доступы к резервной площадке и копиям должны быть хотя бы у двоих.