
В HTML стоит index, а заголовок отдаёт noindex: как найти конфликт
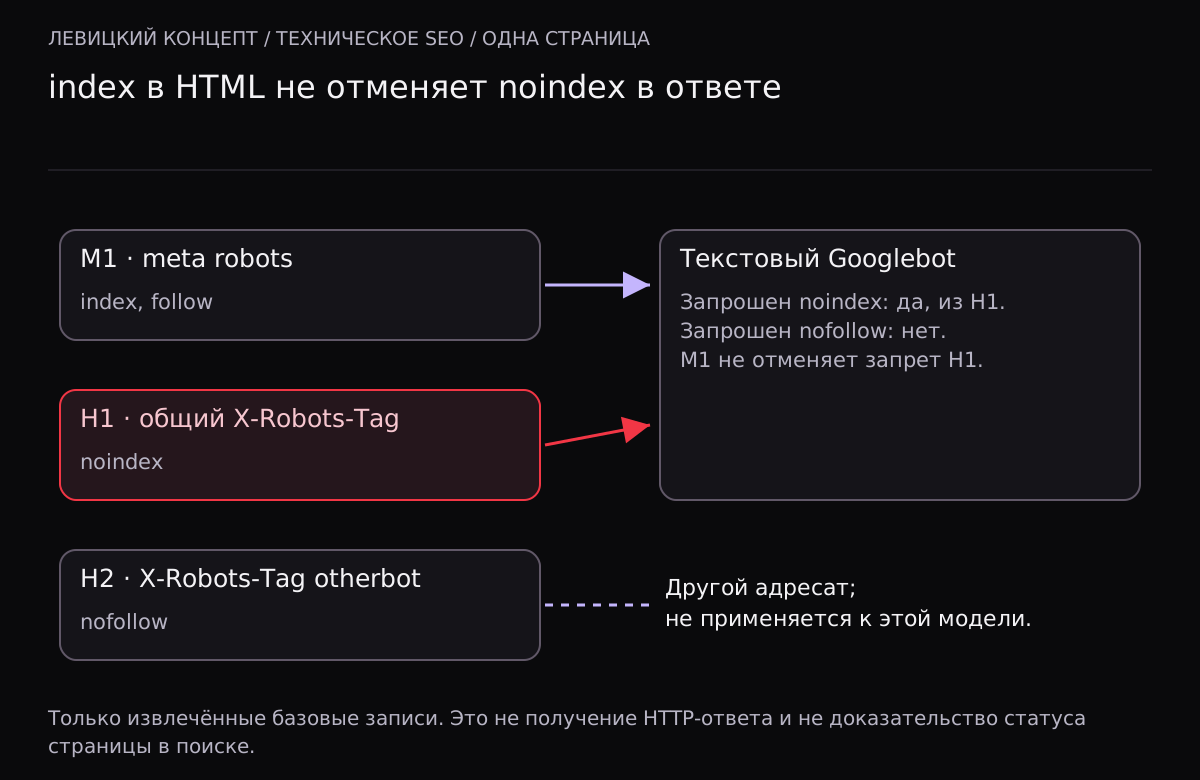
Разработчик открыл HTML, нашёл index, follow и сообщил, что запрет снят. Однако в HTTP-ответе той же страницы остался X-Robots-Tag: noindex. Проверка только одного места даёт неполную картину. Перед продвижением полезно собрать применимые правила вместе и назвать конкретный источник ограничения.
Не выбирайте одно «главное» разрешение
Google описывает robots-метатеги и X-Robots-Tag как способы задать правила для страницы. При конфликте действует более ограничительное правило. Поэтому наличие index в одном месте не отменяет noindex в другом. Добавить ещё одну разрешающую запись вместо устранения ненужного запрета — недостаточная проверка.
Это не спор о том, какой файл важнее. Общие и применимые к Googlebot записи нужно рассматривать совместно. При этом правила для другого адресата нельзя автоматически переносить на текстовый поиск Google.
| Извлечённые записи | noindex в применимом наборе | nofollow в применимом наборе | Что проверить |
|---|---|---|---|
| meta robots: index, follow; общий HTTP-заголовок: noindex | Да | Нет | Откуда сервер добавляет HTTP-запрет |
| meta robots: noindex, follow; общий HTTP-заголовок: index | Да | Нет | Почему метатег сохранился в HTML |
| meta robots: all; meta googlebot: nofollow | Нет | Да | Нужен ли адресованный Googlebot запрет ссылок |
| Общий HTTP-заголовок: index, follow; HTTP для otherbot: noindex | Нет | Нет | Не приписан ли чужой адресат Googlebot |
Два последних столбца не сообщают, находится ли страница в индексе. Они описывают только выбранные инструкции в переданном наборе. Положительный результат по доступности не превращается в обязанность поисковика добавить адрес в выдачу.
Как выглядит источник расхождения
Учебный фрагмент одного ответа: сначала HTTP-заголовки, после пустой строки — HTML. Разрешение внутри документа не удаляет заголовок над ним.
HTTP/1.1 200 OK
Content-Type: text/html; charset=utf-8
X-Robots-Tag: noindex

<!doctype html>
<html><head>
  <meta name="robots" content="index, follow">
</head><body>...</body></html>
Запишите происхождение каждой строки
Для метатега сохраните его name и content. Для X-Robots-Tag отдельно укажите область: общий заголовок без адресата либо значение для конкретного робота. Если сервер вернул несколько таких заголовков, не оставляйте только последний при переносе в таблицу.
Работайте с одной конкретной страницей и одним проверенным ответом, а не смешивайте HTML с рабочей версии и заголовки тестового домена. В журнале проверки полезно сохранить полный URL, время, HTTP-статус, заголовки и способ получения HTML. Один снимок не доказывает одинаковое поведение всех шаблонов сайта.
Как заполнить локальную проверку
Каждая строка содержит технический ID, место, область и список директив. Для meta общая область называется robots; для header — all. Адресованная область googlebot применяется в обоих случаях. Иное имя сохраняется в отчёте как не применяемое к выбранной модели текстового Googlebot.
Вводятся уже извлечённые записи. Не вставляйте целый тег или HTTP-ответ в поле директив: форма не разбирает такую разметку и не получает страницу по сети. Разделение области заголовка с несколькими адресатами нужно выполнить до ввода. Если происхождение строки непонятно, сначала сохраните исходный ответ и уточните разбор.
Смотрите на список источников запрета
В примере H1 добавляет общий noindex. M1 с index, follow его не отменяет. H2 относится к другому роботу и не добавляет nofollow для выбранного адресата. Отчёт показывает IDs применимых источников каждого запрета, поэтому исправление можно связать с конкретным слоем формирования страницы.
Пустой набор допустим и означает отсутствие этих базовых ограничений в предоставленных данных. Он не означает, что в настоящем ответе нет скрытого заголовка. Также инструмент не определяет, какой плагин, серверный конфиг или промежуточный слой добавил строку: это задача отдельного исследования.
Что будет, если робот не может прочитать страницу
Google указывает, что такие настройки можно получить и обработать только при доступе к странице. Запрет обхода в robots.txt и правило noindex решают разные задачи. Локальное сведение директив не доказывает, что робот их увидел, и не определяет сроки изменения поисковой выдачи.
Как завершить проверку после исправления
- Повторно получить тот же URL и сравнить фактические заголовки с предыдущим ответом.
- Проверить, не осталось ли другой применимой записи с запретом.
- Сверить несколько страниц затронутого шаблона, а не только главную.
- Отдельно проверить доступность обхода и данные инструмента проверки URL в Search Console.
При заказе технического SEO у Левицкий Концепт приложите исходные ответы и ожидаемое поведение нужных страниц. Такой пример помогает сформулировать исправление проверяемо: какая запись должна исчезнуть, где она создаётся и как подтвердить результат. Работа с остальными причинами отсутствия страницы в поиске продолжается отдельно от этого ограниченного анализа.
Свести базовые robots-правила для текстового Googlebot
Только извлечённые вручную записи одной страницы для Googlebot текстового поиска. Места meta/header, отдельная область каждой записи. Поддерживаются index, follow, noindex, nofollow, all и none. До 60 строк, пустой ввод допустим. Не парсит HTML/HTTP, robots.txt, сниппеты, indexifembedded, даты, каноникализацию или JavaScript. Нет запросов к сайту и доказательства индексации. Расчёт выполняется на вашем устройстве, введённые данные никуда не отправляются.
Материалы для проверки
Если нужна реализация
Состав работ зависит от текущего проекта и подтверждённой причины. Можно обсудить диагностику или разработку подходящего решения.